

Ja - der Begriff hierzu heißt "Serialisieren/Deserialisieren".
Man nimmt eine Datenstruktur in einer Programmiersprache und speichert diese als Datei so ab, dass die Hierarchie und die Datentypen erhalten bleiben.
Anschließend kann man diese Datei wieder irgendwann einlesen und erhält genau diese Datenstruktur wieder in seinem Programm.
Bei den Formaten bist du ziemlich frei. Du kannst dir was völlig eigenes überlegen oder vorhandene Formate hierfür verwenden.
Ini z.B. ist halt beschränkt, da dort Verschachtelungen nicht gut umsetzbar sind aber wenn deine Datenhierarchie flach ist, kann ini ein guter Kandidat hierfür sein.
Für beliebig verschachtelte Datenstrukturen käme z.B. XML in Frage aber da ist mir keine UDF bekannt, welche direkt aus AutoIt-Strukturen lesen und in diese schreiben kann.
Da müsstest du also was eigenes drumherum basteln.
Bleiben noch die klassischen Kandidaten für diese Aufgabe: >>JSON<< - als (menschenlesbares) Textformat oder >>CBOR<< als (speicherkompaktes) Binärformat.
Das schöne an solchen standardisierten Formaten ist es, dass man problemlos zwischen Programmen die Daten austauschen kann.
Also eine JSON oder CBOR-Datei, welche aus AutoIt heraus erzeugt wurde, kann dann wieder in Python eingelesen werden und dort weitergearbeitet werden.
Beiträge von AspirinJunkie
-
-
Das ist weniger eine Frage von ShellExecute als mehr von dem Programm was am Ende ausgeführt wird.
ShellExecute schaut lediglich in der Registry nach mit welchem Programm eine Dateiendung verknüpft ist wie diese aufzurufen ist (Siehe Zweig HKEY_CLASSES_ROOT).
Im Falle vom Acrobat sollte (hab kein Acrobat) sowas in der Art stehen: "C:\...\acrobat.exe" "%1"Sprich: Der Acrobat-Reader wird gestartet und bekommt den Dateinamen als Parameter übergeben.
In deinem Fall würde im Dateinamen noch ein Sternchen stehen und nun kommt es also darauf an ob der Acrobat Reader mit Sternchen als Wildcards umgehen kann oder eben nicht.
Offensichtlich kann es der Acrobat Reader ja nicht.
Also musst du dir anders behelfen und da gibt es die Möglichkeit dem Reader mehrere Dateinamen zu übergeben.
Also wie Moombas sagte die Dateiliste erzeugen und als mehrere Parameter dem Acrobat Reader überreichen. -

aber was geschieht wenn man in meinem beispiel 2mal homepage vorkommt?
Dann kannst du _td_toPrimaryKeys() halt einfach nicht nutzen, da Primärschlüssel nunmal eindeutig sein müssen.
wie geht man dann mit den daten um?
So wie du es brauchst und es sinnvoll ist.
Du kannst die Daten als 2D-Array behandeln, wenn du $mData.Data nimmst.
Du kannst einzelne oder mehrere Spalten per Name extrahieren wenn du _td_getColumns() verwendest.
Du kannst Prinzipiell spaltenorientiert arbeiten, wenn du _td_toColumns() nimmst.
Du kannst die Datensätze mit _td_toObjects() als Liste von Objekten behandeln, so dass du auf deren Attribute einfach per Name zugreifst.
Du kannst die Daten anzeigen lassen (_td_Display), als csv-formatierten String ausgeben (_td_toCsv), als fixed-width-String ausgeben (_td_toFixWidth) oder als Array ausgeben (_td_toArray).
Es kommt halt ganz auf den Anwendungsfall an.
Zu allen Funktionen habe ich im example-Ordner Beispiele und die jeweiligen Funktionsheader sollten auch hilfreich sein. -
Ja das ist das Konzept der UDF.
Die Daten werden vom Header getrennt behandelt.
Auf die Art kann man die Spalten und Attribute über die Namen ansprechen.
Das bedingt aber halt, dass Headerinformationen da sind.Ein Blick in die Funktionsbeschreibung zeigt auf welche Arten man diese Header-Informationen per $vHeader-Parameter erhalten kann:
- False: Es gibt keine Headerinfos - der User kann selbst im Nachgang diese hinzufügen, wenn er $mTable.Header mit einem entsprechenden 1D-Array beschreibt
- True: Die erste Zeile enthält den Header
- Array: Der User setzt eigene Headerelemente per Array
- String: Der User setzt eigene Headerelemente per String (getrennt durch $sDelim - meistens "|")
-
AutoIt
Alles anzeigen#include "TableData.au3" ; Transfer data to table type: $mData = _td_fromCsv("Test.csv", ',', "", True) ; display data _td_display($mData, "MojoB`s CSV") ; Zugriff per Unique-Key $mTable = _td_toPrimaryKeys($mData) MsgBox(0, "homepage", $mTable.homepage.WERT)Du hast beim Einlesen mit _td_fromCsv() angegeben, dass in der CSV-Datei keine Header-Zeile vorhanden ist (4. Parameter = False).
Die Spalten haben also keinen zugeordneten Namen, stattdessen wurde die Header-Zeile als normale Datenzeile behandelt.
Da die Spalten keinen Namen haben kann auch _td_toPrimaryKeys nichts mit diesen Bezeichnungen anfangen. -
Ohne Daten kann ich nicht weiterhelfen.
-
OK ich habe die Benamung der "-to"-Funktionen jetzt komplett umgestellt und auch die vorgeschlagene Funktion _td_toPrimaryKeys() mit aufgenommen (Danke Moombas für die gute Idee).
Wer für die Funktion evtl. einen schmissigeren Namen hat - gerne her damit - ich bin noch nicht ganz zufrieden damit.
Außerdem ist noch eine kleine Funktion _td_toArray dazugekommen. -
Hm ne würde ich ungern machen.
Neben der weiter anwachsenden Parameteranzahl würde ich auch ein paar "Prinzipien" in der UDF durcheinander hauen.
Die _td_fromXXX-Funktionen haben gemeinsam, dass Sie alle das Table-Objekt mit .data und .header zurückgeben.
Funktionen, welche diese dann je in andere Strukturen umwandeln, kommen dann danach als zweiter Schritt.
Also die Funktionen _td_toColumns, _td_getColumn, _td_TableToMaps.
Diese Funktion hier würde sich vom Ansatz her in letztere einordnen.
Bei der Gelegenheit fällt mir aber auf, dass die Funktionsnamen noch nicht optimal sind.
Wenn ich auf der einen Seite "-from"-Funktionen habe, dann sollten die anderen konsequent "-to"-Funktionen heißen.
Das werde ich wohl sicher so noch mal überarbeiten. -

Es soll nur an Tagen, die in folge das gleiche Datum haben, wie im Beispiel 05.10. 4x oder 11.10. 3x geschehen.
Schnell umgesetzen könnte man das so:
AutoIt
Alles anzeigen#include <Array.au3> Global Const $nTAGESGRENZE = 8 Global $aDate[] = ["01.10", "02.10", "03.10", "04.10", "05.10", "05.10", "05.10", "05.10", "06.10", "07.10", "08.10", "09.10", "10.10", "11.10", "11.10", "11.10"] Global $aValue[] = [8, 10, 8, 6, 2, 4, 10, 2, 6, 6, 6, 6, 6, 2, 8, 2] ; aufpassen: hier hattest du die Werte als Strings - es sollten aber idealerweise Zahlentypen sein Global $aResultValue[UBound($aDate)] Global $sDatum = "", $nWert, $nSumme, $iPos = 0, $iRest = 0 For $i = 0 To UBound($aDate) - 1 $nWert = $aValue[$i] ; Datumswechsel behandeln If $aDate[$i] <> $sDatum Then $sDatum = $aDate[$i] $nSumme = 0 $iPos += $iRest $iRest = 0 EndIf If $nSumme < $nTAGESGRENZE Then ; solange Grenze noch nicht erreicht wird die Werte dem Zielarray hinzufügen If $nSumme = 0 Or ($nSumme + $nWert <= $nTAGESGRENZE) Then $aResultValue[$iPos] = $nWert > $nTAGESGRENZE ? $nTAGESGRENZE : $nWert Else $aResultValue[$iPos] = $nTAGESGRENZE - $nSumme EndIf $nSumme += $nWert $iPos += 1 Else ; Falls Grenze bereits erreicht nichts machen und die Leerstellen zählen $iRest += 1 EndIf Next ; Ausgabe in ein gemeinsames Array um besser zu sehen Local $aData[UBound($aDate)][3] For $i = 0 To UBound($aDate) - 1 $aData[$i][0] = $aDate[$i] $aData[$i][1] = $aValue[$i] $aData[$i][2] = $aResultValue[$i] Next _ArrayDisplay($aData, "", "", 64, "|", "Datum|Ausgangswerte|Zielwerte") -
Interessanter Ansatz.
Meinst du das in der Art?:AutoIt
Alles anzeigen#include "TableData.au3" ; the origin data Global $aArray[5][4] = [["name", "age", "salary", "married"], ["Max", 25, 5000.50, True], ["Anna", 30, 6000.75, False], ["Peter", 35, 7000.25, True], ["Lena", 28, 5500.50, False]] ; convert into a table object: $mData = _td_fromArray($aArray, True) ; convert into primary key focused data structure: $mTable = _td_dataByPrimaryKey($mData) ; access to the data by primary key MsgBox(0, "Anna`s salary", $mTable.Anna.salary) ; #FUNCTION# ====================================================================================== ; Name ..........: _td_dataByPrimaryKey() ; Description ...: converts a table object into a map in which the data is stored with its primary key ; Syntax ........: _td_dataByPrimaryKey(ByRef $mTable, $vPrimaryColumn = 0) ; Parameters ....: $mTable - table object structured like in this udf ; $vPrimaryColumn - column identifier (integer index or column name as string) ; which holds the unique primary key of the data ; Return values .: Success: a AutoIt-Map where Keys=Primary Keys and value=map of data ; Failure: Null ; @error = 1: wrong format of $mTable ; @error = 2: not enough header elements ; @error = 3: wrong datype of $vPrimaryColumn (only string or int) ; @error = 4: column name in $vPrimaryColumn is not contained in the header ; @error = 5: wrong column index in $vPrimaryColumn ; @error = 6: values in the column $vPrimaryColumn are not unique ; Author ........: AspirinJunkie ; Last changed ..: 2024-01-18 ; ================================================================================================= Func _td_dataByPrimaryKey(ByRef $mTable, $vPrimaryColumn = 0) If Not IsMap($mTable) Or Not MapExists($mTable, "Header") Or Not MapExists($mTable, "Data") Then Return SetError(1,0,Null) Local $aHeader = $mTable.Header Local $aData = $mTable.Data If UBound($aHeader) < UBound($aData, 2) Then Return SetError(2, UBound($aHeader), Null) ; check for validity of $vPrimaryColumn If IsString($vPrimaryColumn) Then $vPrimaryColumn = _ArraySearch($aHeader, $vPrimaryColumn) If $vPrimaryColumn < 0 Then Return SetError(4, @error, Null) ElseIf IsInt($vPrimaryColumn) Then If $vPrimaryColumn < 0 Or $vPrimaryColumn >= UBound($aData, 2) Then Return SetError(5, UBound($aData, 2), Null) Else Return SetError(3, 0, Null) EndIf ; transfer the data into the primary-key focused map-structure Local $mRet[] For $i = 0 To UBound($aData, 1) - 1 ; check if key is really unique If MapExists($mRet, $aData[$i][$vPrimaryColumn]) Then Return SetError(6, 0, Null) Local $mEntry[] For $j = 0 To UBound($aData, 2) - 1 $mEntry[$aHeader[$j]] = $aData[$i][$j] Next $mRet[$aData[$i][$vPrimaryColumn]] = $mEntry Next Return $mRet EndFunc -
-
Schwere Geburt.
Wenn "7,5,3" "7,1" ergeben soll, deutet das ja darauf hin, dass tatsächlich auf die vollen 8 aufgefüllt wird.
Das beißt sich aber komplett mit dem 11.10. bei dem du erst "leer,8,leer " stehen hattest worauf ich dann meinte "2,2,leer" würde nach der bisherigen Logik eher dort stehn müssen.
Das hast du dann bestätigt und nun erklärst du dem widersprechend die Auffülllogik als die nun anzuwendende.
Für den 11.10. müsste nun also etwas ganz anderes herauskommen - nämlich "2,6,leer"
Ganz ehrlich - streng dich mal bitte mehr an mit deiner Erklärung.
Wenn nun 2,6,leer richtig sein soll, dann wäre mein Skript folgendermaßen anzupassen:AutoIt
Alles anzeigen#include <Array.au3> Global Const $nTAGESGRENZE = 8 Global $aDate[] = ["01.10", "02.10", "03.10", "04.10", "05.10", "05.10", "05.10", "05.10", "06.10", "07.10", "08.10", "09.10", "10.10", "11.10", "11.10", "11.10"] Global $aValue[] = [8, 8, 8, 6, 2, 4, 10, 2, 6, 6, 6, 6, 6, 2, 8, 2] ; aufpassen: hier hattest du die Werte als Strings - es sollten aber idealerweise Zahlentypen sein Global $aResultValue[UBound($aDate)] Global $sDatum = "", $nWert, $nSumme, $iPos = 0, $iRest = 0 For $i = 0 To UBound($aDate) - 1 $nWert = $aValue[$i] ; Datumswechsel behandeln If $aDate[$i] <> $sDatum Then $sDatum = $aDate[$i] $nSumme = 0 $iPos += $iRest $iRest = 0 EndIf If $nSumme < $nTAGESGRENZE Then ; solange Grenze noch nicht erreicht wird die Werte dem Zielarray hinzufügen $aResultValue[$iPos] = ($nSumme + $nWert <= $nTAGESGRENZE) ? $nWert : $nTAGESGRENZE - $nSumme $nSumme += $nWert $iPos += 1 Else ; Falls Grenze bereits erreicht nichts machen und die Leerstellen zählen $iRest += 1 EndIf Next ; Ausgabe in ein gemeinsames Array um besser zu sehen Local $aData[UBound($aDate)][3] For $i = 0 To UBound($aDate) - 1 $aData[$i][0] = $aDate[$i] $aData[$i][1] = $aValue[$i] $aData[$i][2] = $aResultValue[$i] Next _ArrayDisplay($aData, "", "", 64, "|", "Datum|Ausgangswerte|Zielwerte") -

Vermutlich Überbleibsel von copy & paste.
Das ist wohl mehr als wahrscheinlich.
Das ganze Konstrukt schlummert schon seit ca. 5 Jahren auf meiner Festplatte - angefangen als vollumfänglicher csv-Parser.
Aber eine richtige Gesamtidee für eine UDF war nicht wirklich erkennbar.
Daher hatte es eine ganze Weile gebraucht um da eine sinnvolle Klammer drumherum zu machen.
Bei der abschließenden Fleißarbeit drumherum (Kommentare, Beispiele etc.) werden wohl auf die Art ein paar Schnitzer reingelangt sein. -
Summe= 16, also muss die 3. Zahl = 10, durch die 3. Zahl = 2 ersetzt werden. Dann Summe 8 erreicht!
Jetzt nochmal gaaanz konkret: Wo kommt die 2 her? Ist das nun die 2, welche an 4. Stelle steht (du schreibst ja 3. Zahl = 2....
 ).
Also wäre das so wie ich schon oben vermutete: Die 10 wird ausgelassen, da sie das Limit sprengen würde.
Oder ist die der Anteil der 10, welcher noch zur 8 fehlt.Machen wir es am besten an einem abgewandelten Beispiel:
Folge 2, 3, 10, 2 -> wie sieht die resultierende Folge hierbei aus: 2,3,2 oder 2,3,3 ?
Edit: Falls 2,3,2 zutrifft, dann würde ich diese Logik quick and dirty folgendermaßen umsetzen:AutoIt
Alles anzeigen#include <Array.au3> Global Const $nTAGESGRENZE = 8 Global $aDate[] = ["01.10", "02.10", "03.10", "04.10", "05.10", "05.10", "05.10", "05.10", "06.10", "07.10", "08.10", "09.10", "10.10", "11.10", "11.10", "11.10"] Global $aValue[] = [8, 8, 8, 6, 2, 4, 10, 2, 6, 6, 6, 6, 6, 2, 8, 2] ; aufpassen: hier hattest du die Werte als Strings - es sollten aber idealerweise Zahlentypen sein Global $aResultValue[UBound($aDate)] Global $sDatum = "", $nWert, $nSumme, $iPos = 0, $iRest = 0 For $i = 0 To UBound($aDate) - 1 $nWert = $aValue[$i] ; Datumswechsel behandeln If $aDate[$i] <> $sDatum Then $sDatum = $aDate[$i] $nSumme = 0 $iPos += $iRest $iRest = 0 EndIf If $nWert + $nSumme <= $nTAGESGRENZE Then ; solange Grenze noch nicht erreicht wird die Werte dem Zielarray hinzufügen $aResultValue[$iPos] = $nWert $nSumme += $nWert $iPos += 1 Else ; Falls Grenze bereits erreicht nichts machen und die Leerstellen zählen $iRest += 1 EndIf Next ; Ausgabe in ein gemeinsames Array um besser zu sehen Local $aData[UBound($aDate)][3] For $i = 0 To UBound($aDate) - 1 $aData[$i][0] = $aDate[$i] $aData[$i][1] = $aValue[$i] $aData[$i][2] = $aResultValue[$i] Next _ArrayDisplay($aData, "", "", 64, "|", "Datum|Ausgangswerte|Zielwerte") -
Die Zeilen sollen ab Erreichung der Summe 8, keine Inhalte mehr haben.
Eben das Prinzip sehe ich noch nicht ganz deutlich klar an deinem Beispiel.
Gehen wir mal durch:
Der 5.10.:- 1. Zahl = 2 -> bleibt stehen
- 2. Zahl = 4 -> Summe = 6 -> 4 bleibt stehen
- 3. Zahl = 10 -> Summe = 16 -> es steht da nun eine 2 - warum? ist das die 2 die danach kommt und die 10 wird stattdessen einfach "gelöscht"?
- 4. Zahl = 2 -> leer, da wohl vorher bereits die Summe von 8 erreicht wurde
Der 11.10.:
- 1. Zahl = 2 -> leer obwohl 8 noch nicht erreicht wurde - warum ist die Zelle leer?
- 2. Zahl = 8 -> 8 bleibt stehen obwohl Zwischensumme ja 10 gewesen wäre - warum?
- 3. Zahl = 2 -> leer, da wohl die 8 vorher bereits greift
Verstehst du, dass ich da noch Probleme habe deine Berechnungsvorschrift nachzuvollziehen?
Wenn ich die Logik vom 5.10. auf den 11.10. übertrage, würde bei mir 2 und 2 stehen bleiben.
Wie entscheidest du also welche der möglichen Kombinationen am Ende stehen bleibt.
Einfach von vorn durchgehen scheint es ja offensichtlich nicht zu sein. -
Gibt es denn immer eine Kombination die klappt?
Was passiert wenn an einem Tag nur zwei 2en stehen oder nur zwei 7en?
Welche Vorschrift gilt denn um die "richtige" Kombination auszuwählen?
Mir sind auch nicht klar wie die Lücken in deinem $aResultValue entstehen:
Beim 05.10. ist die Lücke an letzter Stelle, was ich mir erkläre, dass einfach die an der Kombination beteiligten nacheinander eingetragen wurden.
Dann aber wieder ist die Lücke beim 11.10. gleich am Anfang.
Hier bedarf es sicher noch besserer Erklärung und vor allem weiterer konkreter Beispiele. -
Worum geht es?
In AutoIt haben wir es oft mit tabellenartig strukturierten Daten zu tun.
Je nach Quelle müssen wir teils einen erheblichen Codeaufwand betreiben um die Daten in eine Form zu bringen, mit der wir weiterarbeiten können.
Anschließend wird das Arbeiten mit diesen Daten auch nicht unbedingt einfacher, da wir, anstatt auf die sprechenden Namen der Attribute der Daten zuzugreifen, wir es mit numerischen Indizes zu tun haben bei denen man sehr schnell die Übersicht verliert.Beide Probleme werden durch die UDF adressiert.
Im Grundansatz arbeitet die UDF mit einem Table-Objekt (lediglich eine AutoIt-Map), in welcher die Daten vom Header getrennt werden.
Das ermöglicht eine sauberere Prozessierung der Daten.
Sie bietet Funktionen um aus verschiedenen Quellen Daten einzulesen (CSV, Array, string with fixed-width-columns, Strings mit eigenen Spaltentrennungen).
Innerhalb dieses Aufrufes werden die Daten vom Header getrennt oder diesen überhaupt erst Headerdaten hinzugefügt.
Die Daten werden dann entsprechend ihrem Format aufgearbeitet (bei csv Quotes und Escapes entfernt, bei fixed-width Leerräume entfernt...).
Darüber hinaus kann der User direkt für jede Spalte einzeln festlegen wie genau die Daten aufgearbeitet werden sollen. Er ist hierbei komplett frei.
Auf diese Art erhalten die Daten bereits beim Einlesen das Endformat in welchem sie weiterverarbeitet werden sollen.Anschließend können die Daten spaltenbasiert oder Attributbasiert behandelt werden.
Sprich: Anstatt mit Indizes können auch einfach die Attributnamen der Daten verwendet werden - das ermöglicht eine bessere Übersichtlichkeit im Code.Beispiel (umfangreiche weitere Beispiele im Unterordner "examples")
Wir möchten die offenen Ports auf einem Rechner mit AutoIt auswerten.
Der Kommandozeilenbefehl lautet hierfür netstat -t und bringt uns folgende Ausgabe (bei euch je nach System evtl. anders strukturiert):CodeActive Internet connections (w/o servers) Proto Recv-Q Send-Q Local Address Foreign Address State tcp 0 116 192.168.64.110:ssh 192.168.29.200:65069 ESTABLISHED tcp 0 0 192.168.64.110:ssh 192.168.29.200:65068 ESTABLISHEDUm diese Daten sinnvoll weiterzuverarbeiten müssen wir gegebenenfalls folgende Schritte in AutoIt durchführen:
- Löschen der ersten unnützen Zeilen
- Extraktion der Kopfzeile (sie wird anders behandelt als die Daten)
- Erzeugung eines Arrays mit korrekter Dimension um die Daten zu halten
- Trennung der Daten entweder anhand von Leerräumen oder anhand der jeweils festen Spaltenbreite
- Befreiung der Daten von unnötigen Leerräumen
- Konvertierung der Recv-Q und Send-Q-Spalte in einen Zahlendatentyp (für Sortierung usw)
- Auftrennung der Adressdaten in IP-Adresse und Port
Das kann eine Menge (fehleranfälligen) Code-Aufwand bedeuten.
Mit dieser UDF hingegen kann man das ganze folgendermaßen in einem einzigen Aufruf lösen:AutoIt
Alles anzeigen$sString = 'Active Internet connections (w/o servers)' & @CRLF & _ '' & @CRLF & _ 'Proto Recv-Q Send-Q Local Address Foreign Address State' & @CRLF & _ 'tcp 0 116 192.168.64.110:ssh 192.168.29.200:65069 ESTABLISHED' & @CRLF & _ 'tcp 0 0 192.168.64.110:ssh 192.168.29.200:65068 ESTABLISHED' ; Transfer data to table type by using the size of every column: Global $mData = _td_fromFixWidth($sString, _ "left 6; Number 7; Number 7; StringSplit($x, ':', 2) 24;StringSplit($x, ':', 2) 24;", _ ; column definitions "1-2", _ ; skip row 1 to 2 True) ; first row = header ; display data _td_display($mData)und wir erhalten als Resultat:
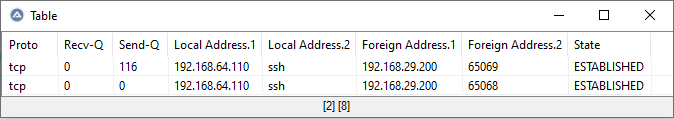
Wenn man nun Funktionen wie _td_toObjects() nutzt, dann kann man die einzelnen Daten mit Ausdrücken wie $aData.Proto oder $aData.State prozessieren.
Das sollte deutlich übersichtlicher sein als sich mit den Arrayindizes herumzuschlagen.Funktionsumfang
Funktion
Beschreibung
Eingabe
_td_fromString konvertiert einen Tabellenartig strukturierten String, bei welchem die Spaltentrenner über einen regulären Ausdruck beschrieben werden können, in ein Tabellenobjekt _td_fromCsv Liest eine Datei oder String in ein Tabellenobjekt, welcher als csv, tsv oder ähnlichem (anpassbaren) Format strukturiert ist. _td_fromFixWidth Konvertiert einen tabellenartig strukturierten String in ein Tabellenobjekt, bei dem die Spalten feste Zeichenbreiten haben (üblicherweise Konsolenausgaben oder printf-Tabellen) _td_fromArray Erzeugt ein Tabellenobjekt aus einem vorhandenen Array Ausgabe
_td_toCsv Konvertiert ein Tabellenobjekt in einen csv/tsv-formatierten String _td_toFixWidth Konvertiert ein Tabellenobjekt in einen String, in welchem die Spalten feste Breiten haben _td_display Stellt ein Tabellenobjekt ähnlich _ArrayDisplay dar (mit Headerbezeichnern und Sortiermöglichkeit) _td_toArray Konvertiert ein Tabellenobjekt in ein 2D-Array bei welchem der Header in der ersten Zeile steht (wenn man nur die Daten haben möchte stattdessen $mTable.Data nutzen) Bearbeitung von Tabellen
_td_join Verknüpft 2 Tabellenobjekte ähnlich wie ein SQL-Join _td_filter Filtert Datensätze in Tabellenobjekten ähnlich zu einem SQL-Where Aufbereitung zur effizienteren Weiterbehandlung
_td_toObjects Konvertiert ein Tabellenobjekt in eine Liste von Datenobjekten. Jeder Eintrag ist damit eine Map bei welcher die Attribute über den Namen angesprochen werden können. _td_MapsToTable Konvertiert eine Liste von Maps (wie von _td_TableToMaps) in ein 2D-Array _td_toPrimaryKeys Konvertiert ein Tabellenobjekt in eine Map für die Datensätze, bei welcher ein Primärschlüsselattribut der Daten als Key verwendet wird. (ermöglicht Zugriff auf die Daten mit Namen anstatt Indizes) _td_toColumns Konvertiert ein Tabellobjekt in eine Map, welche als Einträge die einzelnen Spalten als 1D-Array enthalten. _td_getColumn Extrahiert eine Spalte aus einem Tabellenobjekt -

Ich kann Dir nicht sagen ob das in der Windowswelt die 8 Byte schon abgerechnet werden oder einfach nur anders angezeigt.
Werden sie nicht.
Können sie auch nicht, da der Ping-Parameter "-l" die gewünschte Größe des Sendepuffers angibt - was in einem ICMP-Paket die Nutzlast ist.
Dieser ist durch die MTU und die Header des Pings (ICMP-Header + IP-Header) begrenzt.
Würde der Windows-Ping frech einfach an dieser Stelle 28 Byte hier runterrechnen wäre der Parameter falsch, da er nicht mehr die Größe der Nutzdaten definiert sondern irgendetwas anderes (den Parameter gibt es nicht für die Ermittlung der MTU - er wird hierfür lediglich missbraucht)
Er würde sogar undefinierte Größen im Bereich 0 bis 27 erzeugen. (negative Angaben...)
Hab es auch gerade hier getestet bei einer definitiven MTU von 1500: ein Ping mit -l 1473 versagt zuverlässig. -
Daher Teste ich immer mit dem ping ziel -f -l 1500....wenn es passt OK,
Das kann dann aber nur in einem Netz mit aktivierten Jumboframes passen.
Bei normalen Ethernet sollte dieser Aufruf immer versagen.
Selbst bei minimaler Funktionalität im Ethernetframe kommt man nicht auf über 1.500 MTU.
Der Aufruf checkt aber hingegen auf eine MTU von 1528 Bytes.
Oder anders ausgedrückt: Wenn ping ziel -f -l 1472 noch durchgeht - dann hast du eine MTU von 1.500 Bytes. -
Ob die MTU zu groß eingestellt ist kannst Du sehr einfach feststellen: ping meinserver.com -f -l 1500
Damit würdest du doch aber auf eine MTU von 1528 testen - oder?
Um zu prüfen ob im Netz eine MTU von 1500 Bytes funktioniert müsste man ja noch IP-Header (20 Byte) und den ICMP-Header (8 Byte) abziehen.
Also wäre der korrekte Befehl um auf eine MTU von 1500 zu prüfen folgender: ping meinserver.com -f -l 1472