Von mir auch noch: viel Vergnügen im Kreise der Liebsten 😊 .
Genießt die entschleunigte Zeit und rutscht gut und gesund in neue Jahr 🎉 .
Viele Grüße
Sven
Von mir auch noch: viel Vergnügen im Kreise der Liebsten 😊 .
Genießt die entschleunigte Zeit und rutscht gut und gesund in neue Jahr 🎉 .
Viele Grüße
Sven
Thanks jalah93190 for your worthy input at this topic.
I think your statement and example is helpful for members here, but please keep in mind (next time): this is the german forum. So please write your posts in german (translate it with AI or use known translator services out there).
Thank you 🤝 .
Best regards
Sven
Hey Danke dir chesstiger ,

[...] sehr gerne mittlerweile DuckDB (fehlt übrigens oben) [...]
DuckDB läuft unter "Andere" 😅 . Wenn ich mich recht erinnere, hattest du hier schon mal dafür sensibilisiert in irgendeinen Thread. Daher Danke, ich schaue mir das Repo. dazu nochmal genauer an 🤝 (sehr spannend).
Interessant auch, dass du speziell mit relationalen DBMS unterwegs bist und nicht mit NoSQL DBs - was aber irgendwie auch einleuchtend ist, wenn du bereits mit vier R-DBMS arbeitest (arbeiten musst/darfst).
---------------
Danke dir und allen anderen erneut für die Teilnahme 👌 .
Viele Grüße
Sven
👍 , Danke ebenso.
Willkommen und viel Spaß hier Hilmi .
Hi Marcel,
ja erscheint mir auch sinnvoll und einfach in der Umsetzung.
Bei anderen Anforderungen hättest du sicherlich mehr Vorschläge erhalten (von anderen auch, meine ich), doch so ist es "relativ" klar/einfach.
Gutes Gelingen weiterhin, ciao.
Viele Grüße
Sven
Danke euch allen bisher 🤝 .
Warum fragst du nach den DBMS?
Erstens aus reiner Neugier.
Zweitens weil man sich über Recherchen/Statistiken zu DBMS im Internet die Verwendung und den Trend anschauen kann, ich jedoch gern einen "echten" Eindruck von Usern aus den verschiedensten Branchen bekommen wollte. Es steckt am Ende nicht viel dahinter und es stellt auch keine große Stichprobe dar. Dennoch interessant einfach.
Viele Grüße
Sven
Dem kann ich nichts hinzufügen, dass sind auch meine beiden meistverwendeten DBMS
@Musashi .
Die Kollegen im Team Data Warehouse bei mir sind "natürlich" klassisch mit MS SQL Server unterwegs, aber auch dort kommt so langsam der Gedanke eines Umstiegs auf, auch wenn sich etwas schwer getan wird, vom alten Standard los zu lassen.
(gute) Erfahrungen mit NoSQL DBs gemacht bisher? Die Frage geht auch an die Mitlesenden allgemein 😁 .
Danke allen für die Teilnahme bisher 🤝 .
Viele Grüße
Sven

Wird MariaDB zu MySQL gerechnet?
Ich würde sagen ja, da es ein fork von MySQL ist. Ich habe es gerade bei MySQL noch ergänzt.
Danke BananaJoe .
Hi zuammen 👋 ,
rein aus Neugier:
Mich interessiert welche DBMS Datenbankmanagementsysteme nutzt ihr?
Egal ob privat oder beruflich, mit welchen arbeitet ihr?
Wer mag kann gern auch etwas Kontext dazu schreiben (Einsatzgebiet usw.). Aber wie immer kein Muss.
Mir geht es hier nicht darum, was ihr jemals ausprobiert habt sondern was ihr "öfter" im Einsatz habt oder ihr zumindest irgendwie mit related seid.
==> Danke für die Teilnahme und noch einen angenehmen Tag euch ✌️ .
Viele Grüße
Sven
Dein Vorschlag stammt vom 19. November - die letzte Aktivität von hipfzwirgel war laut seinem Profil aber der 17. November. Er hat ihn daher vermutlich noch gar nicht gelesen.
Danke dir
@Musashi . Die Mühe habe ich mir nicht gemacht, zu schauen wann er das letzte Mal aktiv war.
Meine Annahme ist (eigentlich) immer, dass wenn eine Frage gestellt wird, der Fragende an einer schnellen Antwort interessiert ist und "ständig" auf Antworten prüft. Zumindest mache ich das so, bzw. lasse mich über Notifications informieren, damit ich den Zeitpunkt nicht verpasse. Doch da ich nicht von mir auf andere schließen kann und sollte, wäre die kurze Prüfung wie durch dich durchgeführt ausreichend gewesen 😅 🤝 .

Ich hatte den Vorschlag gesehen aber ich befinde mich derzeit nicht @home und das auch noch für die nächsten drei Wochen. Da ich solange keinen Zugriff auf meinen Dienstrechner habe, kann ich den Vorschlag nicht umsetzen, bzw. testen. Bitte entschuldigt...
Alles gut hipfzwirgel .
Viele Grüße
Sven
Dann einen angenehmen freien Arbeitstag Marcel ✌️ .
Ah okay, Danke Marcel. Nun bin ich im Bilde (glaube ich 😅).
Ja klar kannst du das per INI machen oder sonst wie.
Könntest auch jedes Mal die Dateien (html + txt) ziehen, egal ob sich der Inhalt ändert, da doch sowieso nur einmal am Tag das Programm läuft oder?
Im Moment sind beide Dateiinhalte doch eh sehr klein, da würde es keinen Stress auf dem File-Server verursachen, meine ich.
Falls du mit Versionen arbeitest, wäre noch interessant in mit welchem Format? Semantic versioning (SemVer) ist einer der Quasi-Standards, aber ein einfaches hochzählen reicht sicherlich für deinen Anwendungsfalls auch aus.
Könntest vielleicht einfach mit Zeitstempeln arbeiten, dann brauchst du gar keine INI.
Also du könntest verschiedene Ordner haben, die per Zeitstempel benammt sind. Bspw. sowas 20251208-150920 oder ähnlich.
Dann prüfst du einfach ob ein aktuellerer Ordner vorhanden ist, und ziehst dir dort dann die html und txt, die in jedem Ordner hinterlegt sind.
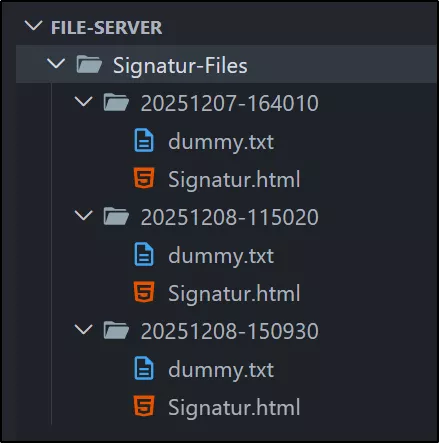
Da gibt es N verschiedene Varianten. Ich kenne deinen Anwendungsfall nicht im Detail und weiß auch nicht ob du noch viel skalieren musst oder willst, in irgendeiner Hinsicht. Doch keep it simple.
Ein Aufruf mit IniRead um die aktuelle Version zu lesen ist gut aus meiner Sicht.
Viele Grüße
Sven
Hi Marcel 👋 ,
ich habe deine Frage nicht richtig verstanden fürchte ich. Du liest im Moment von @ScriptDir ein, Zeile 76.
; --- HTML-Datei einlesen ---
Local $sFile_html = @ScriptDir & "\Signatur-Files\Signatur.html"
Nun möchtest du aber prüfen, ob es eine neue Datei bzw. einen neuen Inhalt (html und/oder txt Datei) gibt und diesen verwenden, richtig?
Wo ist nun deiner Frage? Also kannst du nicht vom freigegebenen zentralen Ordner lesen oder wo ist das Problem?
Dein Programm läuft ja auch nur einmal, richtig? Also es wird nicht offen gehalten um per polling (aller N Minuten) mal zu prüfen ob es was neues gibt usw., richtig?
Dann brauchst du doch sowieso ein Mechanismus um zu wissen, wann eine Änderungen vorhanden ist usw.
Sorry, bitte formuliere dein Ziel und deine Frage nochmal (für mich) neu 😅 , Danke dir 🤝 .
Viele Grüße
Sven
Irgendwelche Gedanken zu meinem Vorschlag hipfzwirgel ?
Hi hipfzwirgel 👋 ,
bin mir nicht sicher ob ich dich richtig verstehe, doch mit AutoIt allein, ohne bspw. über WebDriver zu gehen, wirst du den Titel der jeweiligen Webseite nicht ändern können. Du meinst den HTML <title>...</title> Tag, woraus der Firefox-Tab-Text entsteht, richtig?
Falls ja, dann kannst du folgendes tun (fixe Idee):
Rufe ein vorbereitetes Bookmark (Browser Lesezeichen) mit ein paar AutoIt Send-Befehlen auf. Im bookmark ist nicht wie üblich eine URL zu 'ner Webseite sondern JavaScript Code. Damit kannst du in die aktuelle Seite JS injizieren.
Der JS Code sieht so aus:
Nun musst du nur noch in deinen Ablauf nach jedem einzelnen ShellExecute (wie du beschreibst), das Bookmark aufrufen/anklicken über AutoIt und der Titel verändert sich.
Dier "Herausforderung" ist es nun, die injizierten JS Code, also den string "L20" im Bookmark jedes Mal zu ändern, damit du L01, L02 ... L35 etc. als Browser-Tab bekommst.
Das bekommst du aber sicherlich hin.
Falls nicht, melde dich bitte. Auch im Falle das ich dich total falsch verstanden habe.
Viel Erfolg 🤞 und viele Grüße
Sven
Dieses Forum braucht einen „Gefällt mir“-Button.
Like I said thousand times before 👍 .
---------
Tatsächlich sehr interessant die Empfehlung Oscar , Danke 👌 .
Viele Grüße, Sven
Ja dann herzlich willkommen 👋 Seppuku .
Viel Spaß und Erfolg in unseren Reihen hier.
Scheu' dich nicht reichlich Fragen hier los zu werden oder bei Threads beizutragen.
Viele Grüße
Sven
War auch mein erster Gedanke Velted .
Bzw. würde ich eine Map nutzen.
Meine Frage wäre DOheim , warum du überhaupt so eine Funktion hast oder brauchst, mit beliebig vielen Parametern?
Vielleicht kannst du das ganz vermeiden dann musst du auch nicht mit Eval etc. arbeiten.
Wenn du mit den angebotenen Lösungen zufrieden bist, ist das auch für mich in Ordnung, doch persönlich würde ich dem "warum" auf den Grund gehen und es gar nicht erst dazu kommen lassen.
My 13 Cents dazu 😀 .
Viele Grüße
Sven
------------------------
Manche Funktionen gestaltet man ja auch mit einem Leerstring als Vorbelegung für eine Variable, aber es folgen trotzdem noch besetzte Parameter. Deshalb verwende ich für echte leere Variablen die Vorbelegung: NULL.
Finde ich super BugFix , mit NULL zu arbeiten. So initialisiere ich Maps i. d. R. in AutoIt auch, um genau den Leerstring Fall berücksichtigen zu können 🤝 .
Danke dir AspirinJunkie , wie immer hervorragend erklärt 👌 .
Hier mal ein anderer Ansatz, im Falle du kannst/möchtest direkt mit der API response arbeiten.
Vielleicht trifft mein skizziertes Beispiel gar nicht zu, doch evtl. hilft es im Verständnis mit dem Umgang mit JSON (strings).
Mal angenommen du holst dir per cURL (oder anderen Client) dein JSON string (response) von irgendeiner Webseite.
Dann könntest du mit jq (jq.exe) deine Zielstruktur direkt erstellen ohne viel machen zu müssen.
curl -sSL 'https://your-target-website.com/api/get' | jq.exe '{images: .}'
Oder anders, damit es anschaulicher wird: Du hast deinen JSON string in Datei before.json (dies ist der Ersatz für dein cURL Aufruf) [...]
[{"ref":"https://blabla","hash":"3882db"},{"ref":"https://blabla","hash":"3882db"},{"ref":"https://blabla","hash":"3882db"}]
[...] nun kannst du, vorausgesetzt du nutzt unter Windows bash oder einen anderen Linux like Terminal (#werbung-für-vscode),
per cat und jq das gleiche Ergebnis erreichen, in Datei after.json.
cat before.json | jq '{images: .}' > after.json
💡 Ich weiß, viele Voraussetzungen und externe Tools, anstatt direkt mit der JSON.au3 und AutoIt zu arbeiten. Doch je nachdem in welchem Kontext du arbeitest oder mit jemanden arbeitest (Team etc.), ist AutoIt wahrscheinlich weniger im Einsatz als jq.
⚠️ Ich gebe auch hier nochmal den Hinweis, auch wenn ich weiß das AspirinJunkie meinen Beitrag hier richtig einordnen wird und kein JSON.au3 bashing wahrnimmt 😅 😙 :
Wenn ich rein in AutoIt unterwegs bin und mit JSON arbeite, dann ist seine UDF aus meiner Sicht die richtige Wahl, unter den vielen JSON UDFs. Sobald ich mit anderen Sprachen, Frameworks etc. arbeite, sind deren JSON Serializer oder eben jq als Alternative, die bessere Wahl - da mehr geläufig. Dies deckt sich im wesentlichen auch mit dem was er bereits angesprochen hat, JSON einlesen, verarbeiten in der Sprache oder Tool der Wahl und JSON weiter verarbeiten oder ausgeben.
Einen angenehmen Abend euch noch.
Viele Grüße
Sven